データ-セットとは?意味や種類・活用例をわかりやすく解説(データ分析:機械学習:構造化データ:オープンデータなど)
データセットは、データ分析や機械学習、業務改善に取り組む際の土台となる情報の集合です。
言葉は耳にしていても、データベースやファイルとの違い、種類ごとの使い分けまで理解できている人は多くないかもしれません。
たとえば売上記録、顧客アンケート、画像、音声、Webサイトの閲覧履歴なども、目的に沿って整理されればデータセットになります。
本記事では意味や代表的な種類、構造化データ、オープンデータ、機械学習での役割、活用時の注意点までわかりやすく紹介します。
データセットの意味と活用の全体像
それではまずデータセットの意味と、活用における全体像について解説していきます。
目的別に集めて整理されたデータの集合
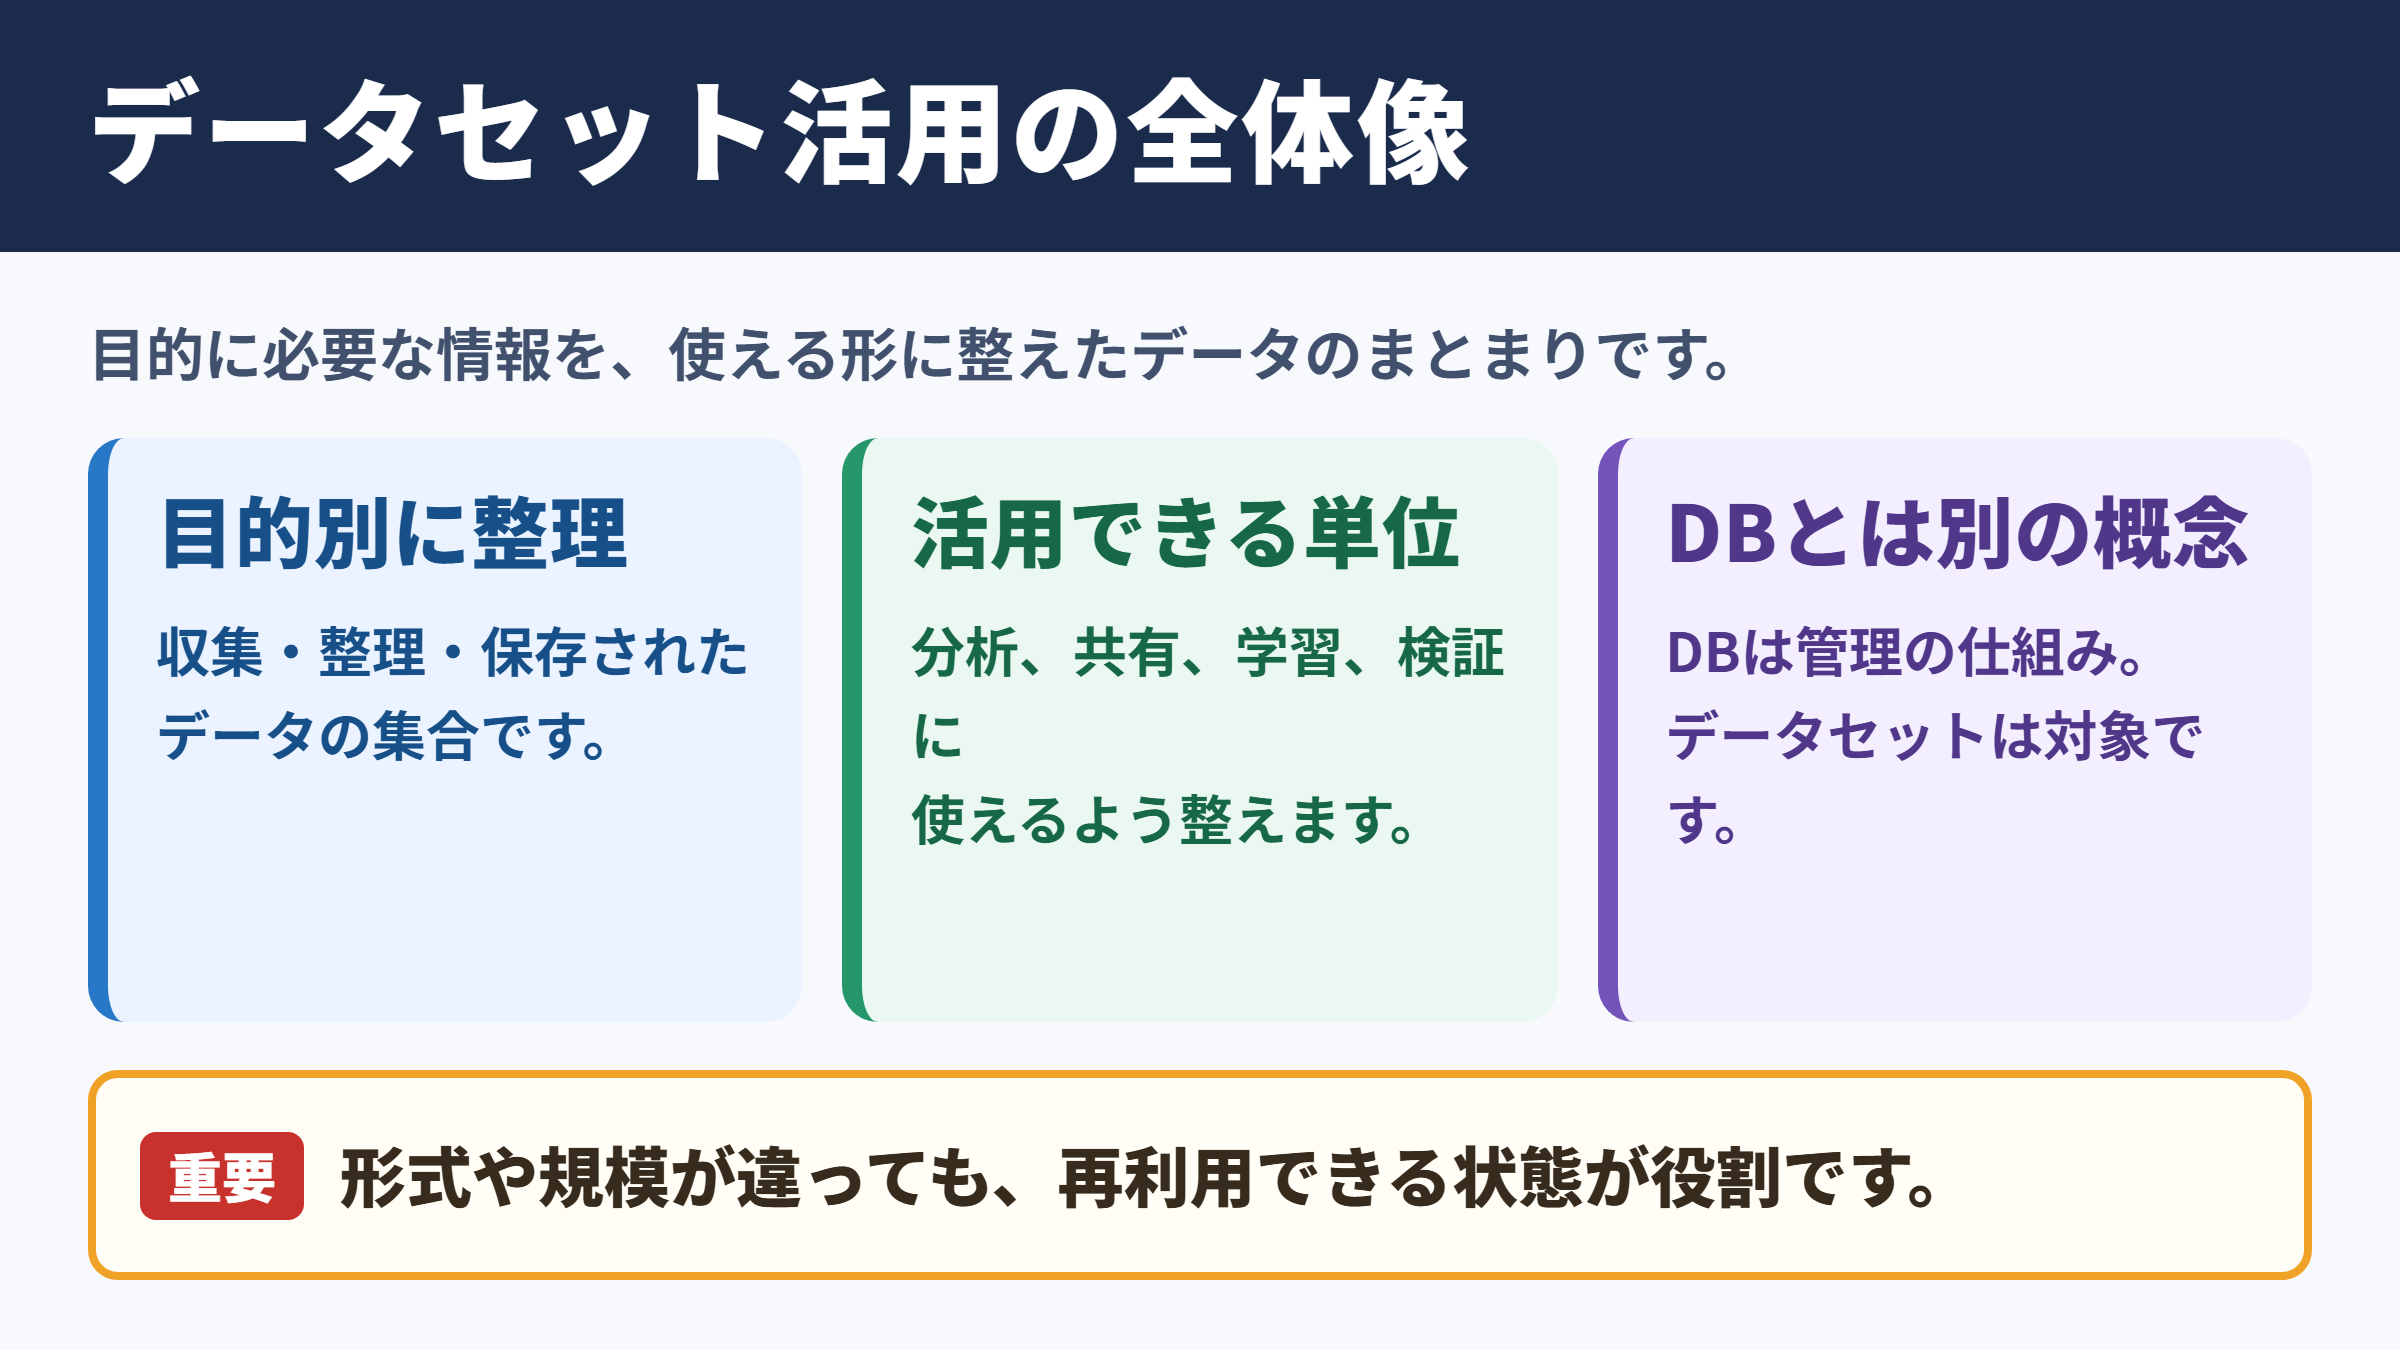
データセットとは、特定の目的のために収集、整理、保存されたデータのまとまりを指します。
単に数字や文章が並んでいるだけではなく、何を示す情報なのか、いつ取得したのか、どの項目に対応するのかがわかる形になっていることが重要です。
小売店の月別売上を例にすると、販売日、商品名、数量、単価、店舗名、購入者の属性などを表形式でまとめたものがデータセットになります。
写真を分類するAIを作る場合は、画像ファイルと、その画像に写る対象を示すラベルを組み合わせた集合がデータセットです。
データセットは情報の保管場所そのものではなく、分析、共有、学習、検証といった目的に使えるよう整えられたデータの単位です。
ExcelやCSVで扱う小規模なものから、クラウド上に蓄積される数億件規模の記録まで、規模や保存形式はさまざまです。
形式が異なっても、目的に必要な情報を再利用できる状態にするという役割は共通しています。
データベースやファイルとの違い
データセットとデータベースは近い概念ですが、意味は同一ではありません。
データベースは、データを効率よく保存、検索、更新するための仕組みや管理システムを指す場合が一般的です。
一方でデータセットは、データベースから取り出した分析対象の一部や、特定テーマに絞って公開されたファイル群を表すことがあります。
CSVファイル一つがデータセットになることもあれば、複数テーブル、画像フォルダ、説明書をまとめて一つのデータセットと呼ぶこともあります。
| 用語 | 主な意味 | 具体例 |
|---|---|---|
| データ | 個別の事実や記録 | 一件の注文金額、気温、写真 |
| データセット | 目的に沿って整理したデータの集合 | 年度別の売上記録、学習用画像集 |
| データベース | データを管理する仕組み | 顧客管理システム、受注管理システム |
| データレイク | 多様な形式のデータを蓄積する基盤 | ログ、動画、CSVを保存するクラウド環境 |
この違いを理解すると、分析担当者との会話や外部データの選定がスムーズになります。
データセットは使う目的と内容に着目する言葉と覚えると整理しやすいでしょう。
意思決定を支える共通の材料
企業活動では、経験や勘だけでなく、客観的なデータに基づく判断が求められる場面が増えています。
その際に判断の材料となるのが、品質を確認したデータセットです。
営業部門なら成約率や商談履歴、製造部門なら設備稼働率や不良品の記録、人事部門なら採用経路や研修受講状況を分析対象にできます。
部署ごとに散らばっていた情報を整理すると、課題の発見や施策の効果測定につながります。
売上成長率の考え方の一例です。
売上成長率 = 当月売上 ÷ 前月売上 − 1
ただし、比較対象の期間、返品処理、税の扱いなどの条件をそろえなければ、計算結果を正しく比較できません。
データセットの価値は件数だけでは決まりません。
必要な項目がそろい、意味が統一され、分析目的に合っていることが成果を左右します。
データセットの種類とデータ形式
続いてはデータセットの種類と、代表的なデータ形式を確認していきます。
構造化データと非構造化データ
データセットは、あらかじめ項目や形式が決められているかによって、大きく構造化データと非構造化データに分けられます。
構造化データは行と列で整理しやすく、集計や検索に向いている形式です。
顧客番号、購入日、商品コード、購入金額のように、各項目の意味が定義された表は構造化データの代表例です。
CSV、Excel、リレーショナルデータベースのテーブルなどで扱われます。
これに対し、画像、音声、動画、自由記述の文章、PDFなどは非構造化データに分類されます。
内容は豊富ですが、そのままでは集計しにくいため、文字起こし、タグ付け、画像認識などの処理を行うケースがあります。
| 分類 | 特徴 | 主な活用例 |
|---|---|---|
| 構造化データ | 項目と型が定義されている | 売上集計、顧客分析、在庫管理 |
| 半構造化データ | 一定の規則はあるが表形式ではない | JSON、XML、Webログ |
| 非構造化データ | 固定の項目構造を持たない | 画像分析、音声認識、文章要約 |
どの形式が優れているかではなく、目的に合うかどうかが判断基準です。
問い合わせ内容を分析したい場合には、文章データに顧客属性や対応結果を組み合わせることで、より深い分析が可能になります。
一次データと二次データ
収集経路という視点では、一次データと二次データにも分けられます。
一次データは、自社調査、実験、アンケート、センサー計測などによって直接取得した情報です。
自社の商品利用者に実施した満足度調査は、一次データにあたります。
目的に合わせて質問や条件を設計できるため、必要な情報を得やすい点が利点です。
二次データは、政府統計、業界団体の調査、公開データ、民間企業のレポートなど、すでに別の目的で収集、公開された情報を利用する方法です。
短時間で幅広い情報を入手しやすい反面、調査方法や更新日、利用条件を確認する必要があります。
外部データを活用する際は、データの出所、調査対象、取得時期、更新頻度、利用ライセンスを必ず確認することが大切です。
一次データと二次データを組み合わせれば、自社の現状と市場全体の傾向を比較しやすくなります。
収集コストと信頼性、目的への適合性を見比べることが選定のポイントです。
時系列データと横断データ
データの観測方法による分類も、分析手法を選ぶうえで役立ちます。
時系列データは、日別、月別、年別のように時間の流れに沿って記録されたデータです。
売上推移、アクセス数、株価、気温、設備の振動値などが代表例となります。
季節変動や長期的な傾向を把握し、需要予測や異常検知につなげやすい特徴があります。
横断データは、ある時点における複数の人、企業、地域、商品などを比較するためのデータです。
たとえば同月の店舗別売上や、回答者別のアンケート結果が該当します。
時系列分析では、前年同月比を使うことがあります。
前年同月比 = 当月の値 ÷ 前年同月の値 × 100
季節による変動が大きい業種では、前月比だけで判断せず、前年同月との比較も行うと傾向をつかみやすくなります。
同じ数値でも、時間軸を含めるか、対象間の違いを見るかで読み取り方は変わります。
データセットの設計段階で、分析したい問いを明確にしておくことが欠かせません。
機械学習におけるデータセットの役割
続いては機械学習におけるデータセットの役割を確認していきます。
学習用データと正解ラベル
機械学習は、データに含まれる規則性をコンピューターに学ばせ、未知の入力に対する予測や分類を行う技術です。
この学習の材料となるものが学習用データセットです。
迷惑メール判定を例にすると、メール本文や送信元などの特徴と、迷惑メールか通常メールかを示す正解ラベルを用意します。
画像分類では、犬や猫などの画像に対応するラベルが必要になります。
入力となる情報は特徴量、予測したい答えは目的変数やラベルと呼ばれます。
何を特徴量に採用するかによって、モデルの精度や説明しやすさは大きく変化します。
| 用語 | 意味 | 売上予測の例 |
|---|---|---|
| 特徴量 | 予測の材料になる入力項目 | 価格、曜日、広告費、天候 |
| 目的変数 | 予測したい結果 | 日別売上額 |
| ラベル | 教師あり学習の正解情報 | 購入あり、購入なし |
| モデル | データから学んだ予測の仕組み | 需要予測プログラム |
ラベル付けには人手がかかることもありますが、曖昧な基準で付与すると学習結果も不安定になりやすいでしょう。
判定基準を書面化し、複数人で確認する工程が品質向上に役立ちます。
訓練用データと評価用データ
一つのデータセットをすべて学習に使うと、学習済みのデータにだけ強いモデルになるおそれがあります。
そのため通常は、訓練用、検証用、テスト用にデータを分けます。
訓練用データはモデルが規則を学ぶために使います。
検証用データは設定や手法を比較する際に用い、テスト用データは最終的な性能を確認するために残しておく役割です。
データ分割の一例です。
全体を100とした場合、訓練用70、検証用15、テスト用15に分ける方法があります。
ただし、時系列データでは未来の情報が過去の学習に混ざらないよう、日付順に分ける必要があります。
この割合は絶対的な正解ではありません。
データ件数、業務上のリスク、予測対象の性質に応じて、適切な方法を選択します。
評価用データを学習の調整に使い過ぎないことも大切です。
最終テスト用のデータを独立させることで、実運用に近い性能を確認できます。
データ品質とバイアス
高性能なアルゴリズムを選んでも、元となるデータセットに偏りや誤りが多ければ、望ましい結果は得にくくなります。
機械学習では特に、入力データの品質がモデルの振る舞いに直接影響します。
たとえば特定の年代や地域のデータだけが極端に多い場合、別の属性に対する予測精度が低下する可能性があります。
過去の人事判断に偏りが含まれていれば、その傾向を学習したシステムにも影響が及ぶでしょう。
機械学習の精度だけでなく、公平性、説明可能性、個人情報保護、利用者への影響を確認する視点が必要です。
欠損値、重複、入力ミス、古い情報、対象の偏りを点検し、必要に応じて補正や除外を行います。
データセットの品質管理はモデル開発の前工程ではなく、運用中も続く取り組みです。
オープンデータと公開データの活用場面
続いてはオープンデータと公開データの活用場面を確認していきます。
オープンデータの基本的な考え方
オープンデータとは、国、地方公共団体、研究機関、企業などが公開し、一定の条件のもとで誰もが利用しやすい形にしたデータです。
再利用、加工、配布を認めるライセンスが設定されている点が重要になります。
人口統計、気象情報、地図情報、公共施設の位置、予算、交通情報などは、オープンデータとして公開される代表的な分野です。
社会課題の解決、行政サービスの改善、新規事業の創出、研究活動などに活用されています。
公開されているからといって、すべてのデータを自由に使えるとは限りません。
利用規約、著作権、出典表示の要否、営利利用の可否、加工後の配布条件を確認しましょう。
業務分析に取り入れる方法
オープンデータは、自社だけでは取得しにくい外部環境を把握する際に役立ちます。
たとえば店舗出店を検討する場合、人口、世帯構成、周辺施設、鉄道利用者数、地域イベントなどの情報を組み合わせられます。
観光事業では、宿泊者数、天候、祝日、交通量のデータを組み合わせることで、繁忙期の予測精度を高められる可能性があります。
製造業では、気象や物流に関する公開情報を仕入れ計画の参考にする場面もあるでしょう。
| 活用目的 | 組み合わせるデータセット | 期待できる分析 |
|---|---|---|
| 出店計画 | 人口統計、地図、競合店舗情報 | 商圏の比較、候補地の評価 |
| 需要予測 | 売上、天気、休日、イベント情報 | 来店数や販売量の予測 |
| 地域施策 | 住民意見、施設情報、移動データ | 課題の把握、施策効果の検証 |
| 研究開発 | 論文付随データ、観測記録、画像 | 仮説検証、再現性の確認 |
外部データと社内データを結び付ける際は、地域コード、日付形式、単位などを統一する必要があります。
結合できる状態に整える作業そのものが、分析の成否を左右します。
信頼性とライセンスの確認
公開データを利用する際には、出所の信頼性を確かめることが欠かせません。
誰が、どのような目的で、どの範囲を対象に、どの方法で収集したのかを確認します。
更新が止まったデータや、調査対象が限定されたデータを現在の全体傾向として扱うと、誤った判断につながるおそれがあります。
メタデータと呼ばれる説明情報を確認し、定義や更新日、欠損の有無を把握しましょう。
ライセンスについては、出典の表示が必要なもの、二次利用に制約があるもの、個人情報を含むため利用目的が限られるものがあります。
利用前に条件を記録し、社内で共有する運用が安全です。
データの中身だけでなく、利用できる権利と責任まで確認することが、継続的な活用につながります。
特に商用サービスへ組み込む場合は、法務部門や専門家への相談も検討するとよいでしょう。
データセット作成と品質管理の手順
続いてはデータセット作成と品質管理の手順を確認していきます。
分析目的と必要項目の設計
良いデータセット作りは、最初に分析目的を具体化するところから始まります。
売上を上げたいという大まかな目的だけでは、収集すべき項目を決めにくいでしょう。
たとえば、来月の商品別需要を予測したい、離反しそうな顧客を把握したい、問い合わせ対応時間を短縮したいというように、問いを具体的に設定します。
次に、その問いに答えるために必要な項目、取得頻度、対象期間、粒度を考えます。
売上予測であれば、販売日、商品、価格、数量、在庫、販促、天候などが候補になります。
ただし、利用できない個人情報や、予測時点では取得できない未来の情報を含めないよう注意が必要です。
目的から項目を考える例です。
問いは、翌週の店舗別来店数を予測できるかというものです。
候補項目は、過去の来店数、曜日、祝日、気温、降水量、近隣イベント、営業時間です。
何のために使うかを先に決めることで、不要な収集や後からの作り直しを減らせます。
データの粒度も重要であり、月次で十分なのか、時間帯別まで必要なのかを判断します。
収集と前処理の実務
データ収集では、社内システム、アンケート、IoT機器、API、公開サイト、外部提供会社など、複数の取得元を扱うことがあります。
収集方法ごとに、取得日時、担当者、抽出条件、更新頻度を記録しておくと、後からの検証が容易になります。
集めた直後のデータには、空欄、表記ゆれ、重複、異常値、文字コードの違いなどが含まれることが少なくありません。
これらを分析しやすい形へ整える処理は、前処理やデータクレンジングと呼ばれます。
| 確認項目 | よくある問題 | 対応例 |
|---|---|---|
| 欠損値 | 年齢や住所が空欄 | 補完、除外、欠損フラグの追加 |
| 表記ゆれ | 東京都と東京、東京都が混在 | 表記ルールに統一 |
| 重複 | 同一注文が二重に登録 | 識別子と日時で照合 |
| 異常値 | 数量が極端に大きい | 入力ミスか実績かを確認 |
| 型の不一致 | 日付が文字列として保存 | 日付型や数値型へ変換 |
前処理で何を変更したのかを記録することも重要です。
元データを残し、加工済みデータと分けて管理すると、結果に疑問が出た際に原因を追跡しやすくなります。
更新とガバナンスの仕組み
データセットは一度作って終わりではありません。
事業内容、システム、顧客行動、法律、外部環境が変われば、データの意味や品質も変化します。
更新担当者、更新頻度、品質確認の方法、利用権限、保管期間を決めておくと、データ活用を継続しやすくなります。
特に複数部署で同じ項目を使う場合は、売上、顧客、契約などの定義をそろえる必要があります。
データガバナンスとは、データを正確、安全、適切に利用するためのルール、責任者、運用体制を整える考え方です。
個人情報や機密情報を含むデータセットでは、アクセス権限の最小化、暗号化、ログの保存、持ち出し制限なども欠かせません。
使いやすさと安全性を両立させる設計が、組織全体でのデータ活用を支えます。
データセット活用のまとめ
データセットとは、分析、共有、機械学習などの目的に合わせて整理されたデータの集合です。
表形式の構造化データだけでなく、文章、画像、音声、ログといった多様な情報も、整理方法によって重要なデータセットになります。
活用の第一歩は、どのような課題を解決したいのかを明確にすることです。
目的に必要な項目、データの粒度、取得期間、更新頻度を決めることで、集めるべき情報が見えてきます。
機械学習では、学習用、検証用、テスト用にデータを分け、偏りや誤りを点検することが重要です。
オープンデータを使う場合は、出所、更新日、利用規約、ライセンスを確認してから活用しましょう。
量が多いだけのデータセットよりも、目的に合い、定義が明確で、品質を確認できるデータセットのほうが価値を生みやすいといえます。
まずは身近な売上記録や問い合わせ履歴などから整理を始め、継続的に改善することが、データ分析を成果へつなげる近道です。